← ส่วนหนึ่งของคู่มือฉบับเต็ม: ทำไม AI ไม่รู้จักแบรนด์คุณ
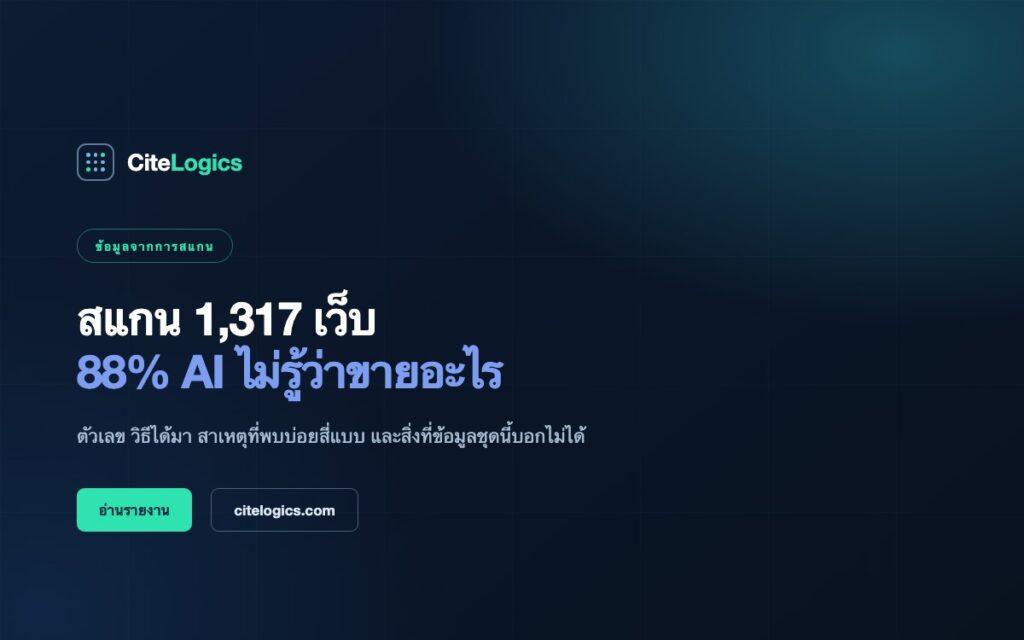
TL;DR: จากเว็บไซต์ 1,317 แห่งที่ผ่านเครื่องมือสแกนของเรา มี 1,158 แห่ง หรือ 88% ที่ AI อ่านแล้วบอกไม่ได้ว่าธุรกิจนั้นขายอะไร ตัวเลขนี้มาจากเครื่องมือของเราเอง ไม่ใช่งานสำรวจเชิงสถิติ และมีข้อจำกัดที่ต้องอ่านก่อนนำไปใช้ต่อ หน้านี้เปิดทั้งตัวเลข วิธีได้มา และสิ่งที่ข้อมูลชุดนี้บอกไม่ได้
ข้อจำกัดของข้อมูลชุดนี้ อ่านก่อน
เราวางส่วนนี้ไว้บนสุดแทนที่จะซ่อนไว้ท้ายบทความ เพราะตัวเลขที่ไม่มีบริบทถูกเอาไปใช้ผิดได้ง่าย ข้อมูลชุดนี้มีข้อจำกัดสี่ข้อที่ต้องรู้
- เป็นกลุ่มตัวอย่างที่เลือกตัวเอง — เว็บทั้งหมดมาจากคนที่ตัดสินใจกดสแกนเอง ไม่ใช่การสุ่มจากเว็บไทยทั้งประเทศ คนที่มาสแกนมักสงสัยอยู่แล้วว่าเว็บตัวเองมีปัญหา สัดส่วนที่ได้จึงน่าจะแย่กว่าค่าเฉลี่ยจริงของเว็บไทยทั้งหมด
- ไม่ใช่งานวิจัย — นี่คือตัวนับผลจากเครื่องมือที่เปิดให้ใช้ฟรี ไม่มีการออกแบบกลุ่มตัวอย่าง ไม่มีการควบคุมตัวแปร และไม่ควรเรียกว่าผลสำรวจ
- วัด ณ เวลาที่สแกน — เว็บที่แก้ไขหลังจากนั้นจะไม่สะท้อนในตัวเลข ข้อมูลเป็นภาพสะสมข้ามช่วงเวลา ไม่ใช่ภาพนิ่งวันเดียว
- วัดโครงสร้าง ไม่ได้วัดผลลัพธ์ — บอกว่าเว็บพร้อมให้ AI อ่านแค่ไหน ไม่ได้บอกว่าธุรกิจนั้นถูก AI แนะนำจริงหรือไม่ ซึ่งเป็นคนละเรื่องกัน
เราเคยใช้ตัวเลขชุดอื่นในการสื่อสารมาก่อนโดยไม่ได้ไล่ที่มาให้ครบ แล้วพบภายหลังว่าอ้างอิงกลับไปไม่ถึงข้อมูลดิบ จึงเลิกใช้ตัวเลขนั้นและเปลี่ยนมาใช้เฉพาะตัวเลขที่ตรวจสอบย้อนกลับได้ หน้านี้คือชุดที่เหลือหลังการคัดออก
ตัวเลขหลัก
| รายการ | จำนวน |
|---|---|
| เว็บไซต์ที่ผ่านการสแกน | 1,317 |
| เว็บที่ AI บอกไม่ได้ว่าธุรกิจขายอะไร | 1,158 คิดเป็น 88% |
| เว็บที่ผ่านเกณฑ์ข้อนี้ | 159 คิดเป็น 12% |
เกณฑ์ที่ใช้ตัดสินคือ เมื่ออ่านหน้าแรกและหน้าบริการในรูปแบบที่บอทเห็น ระบบสามารถระบุได้หรือไม่ว่าธุรกิจนี้ขายสินค้าหรือบริการอะไร ให้ใคร ถ้าตอบไม่ได้จากข้อความที่อยู่ใน HTML ดิบ ถือว่าไม่ผ่าน
สาเหตุที่พบบ่อยที่สุดสี่แบบ
1. เนื้อหาหลักไม่อยู่ใน HTML ดิบ
เว็บที่สร้างด้วยเฟรมเวิร์กฝั่งหน้าบ้านและ render ข้อความด้วย JavaScript ทั้งหมด จะส่ง HTML ที่แทบว่างเปล่าให้บอท บอทเก็บข้อมูลของระบบ AI หลักไม่รัน JavaScript ข้อความที่คนเห็นสวยงามบนหน้าจอจึงไม่มีอยู่ในสายตาของระบบ ทดสอบเองได้ใน 5 นาทีตามวิธีใน ChatGPT เห็นเว็บคุณไหม
2. หน้าแรกพูดถึงคุณค่าแต่ไม่พูดถึงสินค้า
ข้อความแบบยกระดับธุรกิจของคุณไปอีกขั้น หรือ พันธมิตรที่คุณวางใจ ไม่ได้บอกระบบว่าขายอะไร เว็บจำนวนมากใช้พื้นที่ครึ่งหน้าแรกไปกับประโยคลักษณะนี้ แล้วเก็บคำว่าขายอะไรจริงไว้ในหน้าย่อยที่บอทอาจไม่ได้อ่าน
3. ไม่มี Organization schema หรือมีแต่ไม่ตรงกับข้อความจริง
schema ช่วยให้ระบบยืนยันสิ่งที่อ่านจากข้อความได้ เว็บที่ไม่มีเลยจะเหลือแค่การเดาจากข้อความ ส่วนเว็บที่ใส่ schema ไม่ตรงกับสิ่งที่แสดงจริงจะสร้างความขัดแย้งในข้อมูล ซึ่งแย่กว่าการไม่ใส่
4. ชื่อธุรกิจและข้อมูลติดต่อไม่ตรงกันในแต่ละที่
ชื่อบริษัทที่สะกดต่างกันระหว่างเว็บ ข้อมูลธุรกิจบน Google และหน้าโซเชียล ทำให้ระบบไม่แน่ใจว่าทั้งหมดคือรายเดียวกัน ความไม่แน่ใจนี้ลดโอกาสถูกหยิบไปอ้างอิง
สิ่งที่ข้อมูลชุดนี้บอกไม่ได้
ตัวเลข 88% บอกว่าเว็บส่วนใหญ่ยังไม่พร้อมให้ระบบอ่านเข้าใจ แต่บอกไม่ได้ว่า
- เว็บไทยทั้งประเทศมีสัดส่วนเท่าไร เพราะกลุ่มตัวอย่างเลือกตัวเองเข้ามา
- ธุรกิจที่ผ่านเกณฑ์จะถูก AI แนะนำ เพราะความพร้อมเชิงโครงสร้างเป็นเงื่อนไขจำเป็นแต่ไม่พอ ตัวเราเองผ่านเกณฑ์ข้อนี้แต่ยังไม่ถูกเอ่ยชื่อในคำถามเชิงจ้างงานเลยสักครั้ง ดูรายละเอียดที่ ผลทดสอบตัวเอง
- แก้แล้วจะได้ลูกค้าเพิ่มเท่าไร เพราะระยะห่างระหว่างการถูกอ้างอิงกับการเกิดยอดขายขึ้นกับปัจจัยอื่นอีกมาก
ตัวเลขที่ใช้ตัดสินใจได้จริงคือตัวเลขของเว็บคุณเอง ไม่ใช่ค่าเฉลี่ยของกลุ่ม การรู้ว่า 88% มีปัญหาไม่ได้บอกว่าคุณอยู่ในกลุ่มไหน
ตรวจเว็บตัวเองกับเกณฑ์เดียวกัน
- ดึงหน้าแรกด้วย
curlโดยไม่รัน JavaScript แล้วอ่านผลลัพธ์ที่ได้ - หาคำที่บอกว่าขายอะไร ในข้อความที่ได้มา ถ้าไม่มีคำที่ระบุสินค้าหรือบริการชัดเจน ระบบก็หาไม่เจอเหมือนกัน
- อ่าน 200 คำแรก แล้วถามว่าคนที่ไม่รู้จักธุรกิจนี้มาก่อนจะบอกได้ไหมว่าขายอะไรให้ใคร
- ตรวจ Organization schema ว่ามีอยู่และตรงกับข้อความที่ผู้ใช้มองเห็น
- เทียบชื่อและข้อมูลติดต่อ ระหว่างเว็บ ข้อมูลธุรกิจบน Google และหน้าโซเชียลว่าตรงกันทุกที่
ห้าข้อนี้ครอบคลุมสาเหตุที่พบบ่อยที่สุดในกลุ่มตัวอย่าง ทำเองได้ในหนึ่งชั่วโมงและไม่ต้องใช้เครื่องมือพิเศษ
CiteLogics — วัดเว็บของคุณ ไม่ใช่ค่าเฉลี่ยของคนอื่น
AI Visibility Audit ให้คะแนน AIVS ห้ามิติของเว็บคุณเอง พร้อมระบุว่าเสียคะแนนตรงไหนและอะไรเป็นเพดานของแพลตฟอร์มที่ใช้อยู่ เกณฑ์ให้คะแนนเปิดเผยต่อสาธารณะทั้งหมด
- AI Visibility Audit — รายงาน AIVS Score เต็ม พร้อมคุย 30 นาที ราคา 2,000 บาท ส่งภายใน 24 ชั่วโมง คืนเงินได้ใน 7 วัน
- Big Win (Audit + WebFix) — ตรวจพร้อมลงมือแก้ครบทั้ง crawlability โครงสร้าง และ schema ราคา 20,000 บาท
เริ่มจาก สแกน AI visibility ฟรี หรือติดต่อ sales@citelogics.com
คำถามที่พบบ่อย
ตัวเลข 88% ใช้อ้างอิงต่อได้ไหม
อ้างอิงได้ถ้าระบุที่มาให้ครบว่าเป็นข้อมูลจากเครื่องมือสแกนของ CiteLogics จากกลุ่มตัวอย่างที่เลือกตัวเองเข้ามา 1,317 ราย ไม่ควรอ้างว่าเป็นผลสำรวจเว็บไทยทั้งประเทศ เพราะกลุ่มตัวอย่างไม่ได้สุ่ม
ทำไมตัวเลขถึงสูงขนาดนี้
ส่วนหนึ่งเพราะกลุ่มตัวอย่างเอียง คนที่มาสแกนมักสงสัยว่าเว็บตัวเองมีปัญหาอยู่แล้ว อีกส่วนเพราะสาเหตุที่พบบ่อยที่สุดคือเนื้อหาไม่อยู่ใน HTML ดิบ ซึ่งเกิดกับเว็บที่สร้างด้วยเครื่องมือสมัยใหม่จำนวนมากโดยที่เจ้าของไม่รู้ตัว
ผ่านเกณฑ์ข้อนี้แล้ว AI จะแนะนำเราไหม
ยังไม่แน่ ความพร้อมเชิงโครงสร้างเป็นเงื่อนไขจำเป็นแต่ไม่เพียงพอ ยังต้องมีตัวตนที่ยืนยันได้จากแหล่งภายนอกด้วย เว็บของเราเองผ่านเกณฑ์นี้แต่ยังไม่ถูกเอ่ยชื่อในคำถามเชิงจ้างงานเลยสักครั้งตอนวัดครั้งล่าสุด
ข้อมูลนี้เก็บช่วงไหน
เป็นยอดสะสมของเว็บที่ผ่านเครื่องมือสแกน ไม่ใช่ภาพนิ่งของวันใดวันหนึ่ง เว็บที่แก้ไขหลังสแกนแล้วจะไม่สะท้อนในตัวเลข ถ้าต้องการสถานะปัจจุบันของเว็บใดต้องสแกนใหม่
แก้เรื่องนี้ยากแค่ไหน
ขึ้นกับสาเหตุ การเขียนหน้าแรกใหม่ให้ระบุสินค้าชัดเจนและการใส่ schema ใช้เวลาระดับวัน ส่วนกรณีที่เนื้อหาไม่อยู่ใน HTML ดิบอาจต้องแก้ที่วิธี render ซึ่งเป็นงานระดับสัปดาห์และบางแพลตฟอร์มมีเพดานที่แก้ไม่ได้
เขียนโดย
Nipun Kasevayuth
ผู้ก่อตั้งและ CTO, CiteLogics
วิศวกรผู้หลงใหลใน AI ที่ถอดรหัสว่าโมเดล AI เลือกอ้างอิงแบรนด์ไหนจากอะไร เริ่มจากพิสูจน์วิธีกับเว็บของตัวเองก่อน แล้วสร้างผลลัพธ์แบบเดียวกันให้แบรนด์อย่าง Coldtubb รวมสแกนเว็บไซต์เพื่อวัด AI visibility มาแล้วกว่า 1,000 เว็บ
ดูโปรไฟล์ LinkedIn →